단백질 정제를 원해서 정제 직무를 시작했는데, 생각 보다 단백질에 대한 탐구보다 경험적인 approach가 중요하다는 생각이 들었다. 그래서 논문을 좀 읽어보다가 pymol로 연구하는 product의 docking interaction을 보다가 공부를 좀 해보고 싶다는 생각이 들었다.
한국 제약바이오협회 LAIDD에서 서울대약대의 이주용 교수님의 protein-ligand docking에 관련한 'Ligand screening의 인공지능 활용 최신기술' 이라는 강의가 있어 해당 강의를 들으면서 공부를 시작해보려고 한다. Programming과 protein에 대해 어느정도 이해가 있기 때문에, 이해 할수 있었지만 쉽지는 않았다. 그래도 공부에서 가장 중요한 것은 배운 내용을 다시 보고 자신의 언어로 표현하는 것이라고 생각하기 때문에, 이 역시 공부해 보려고 한다. 해당 내용들은 LAIDD 서울대학교 약학대학교 이주용 교수님의 'Ligand screening의 인공지능 활용 최신기술' 강의를 보고 정리한것이라는 것을 밝힌다.
1. Protein-Ligand Docking 이란?
- Docking attempts to find the "best matching" between two molecules. (두 분자 사이의 최적 결합을 찾는 것.)
- Protein-ligand docking is to predict the position and orientation (pose) of a ligand (a small molecule) when it is bound to a protein receptor or enzyme (ligand의 위치와 방향을 예측 하는 것.)
- Finding the global Gibbs free energy minimum conformation (전역 깁스 자유에너지 최소 구조 찾기)
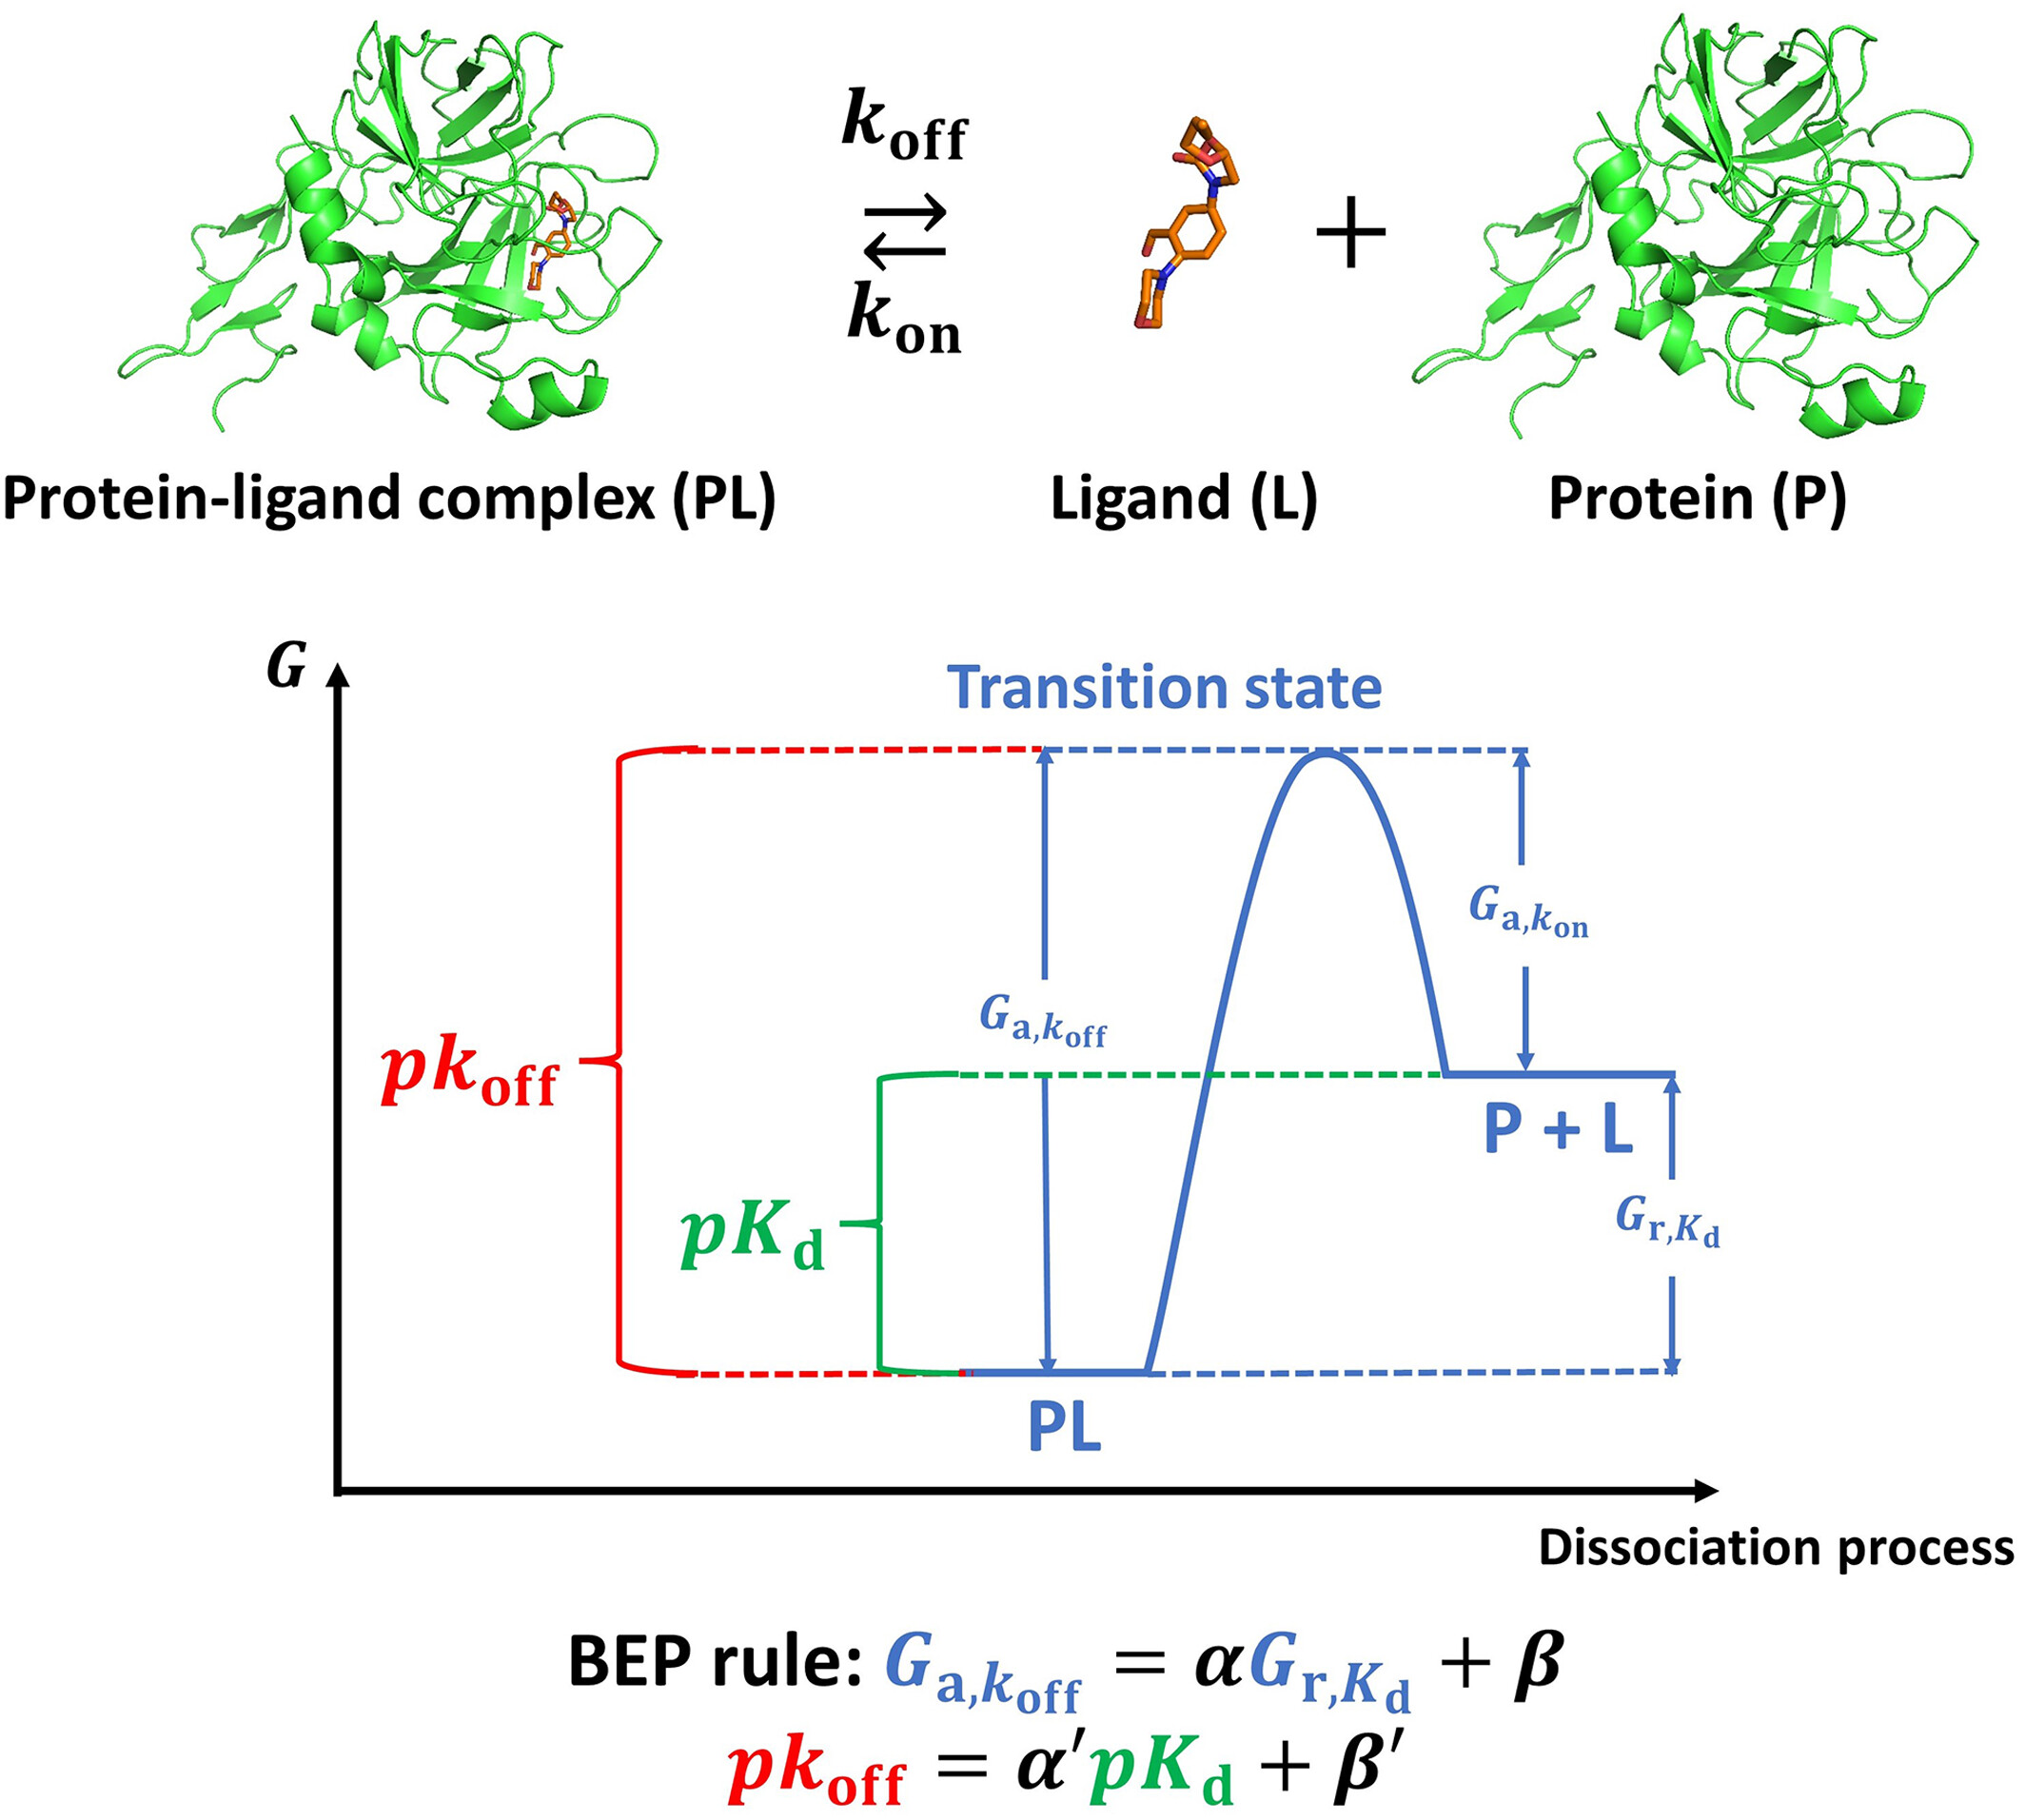
- Protein과 ligand가 분리된 상태(P+L)의 gibbs free energy 에서 complex(PL) 의 gibbs free energy의 차이는 binding affinity 이다. (아래 그림의 Gr = Kd)
- Kd (Disassociation constant) = [Protein][Ligand] / [Protein + Ligand complex] 낮을 수록 (complex가 많을 수록) 결합 친화도가 높다.
- pKd = -log (Kd) 로, Kd를 직관적으로 표현한 식이다.
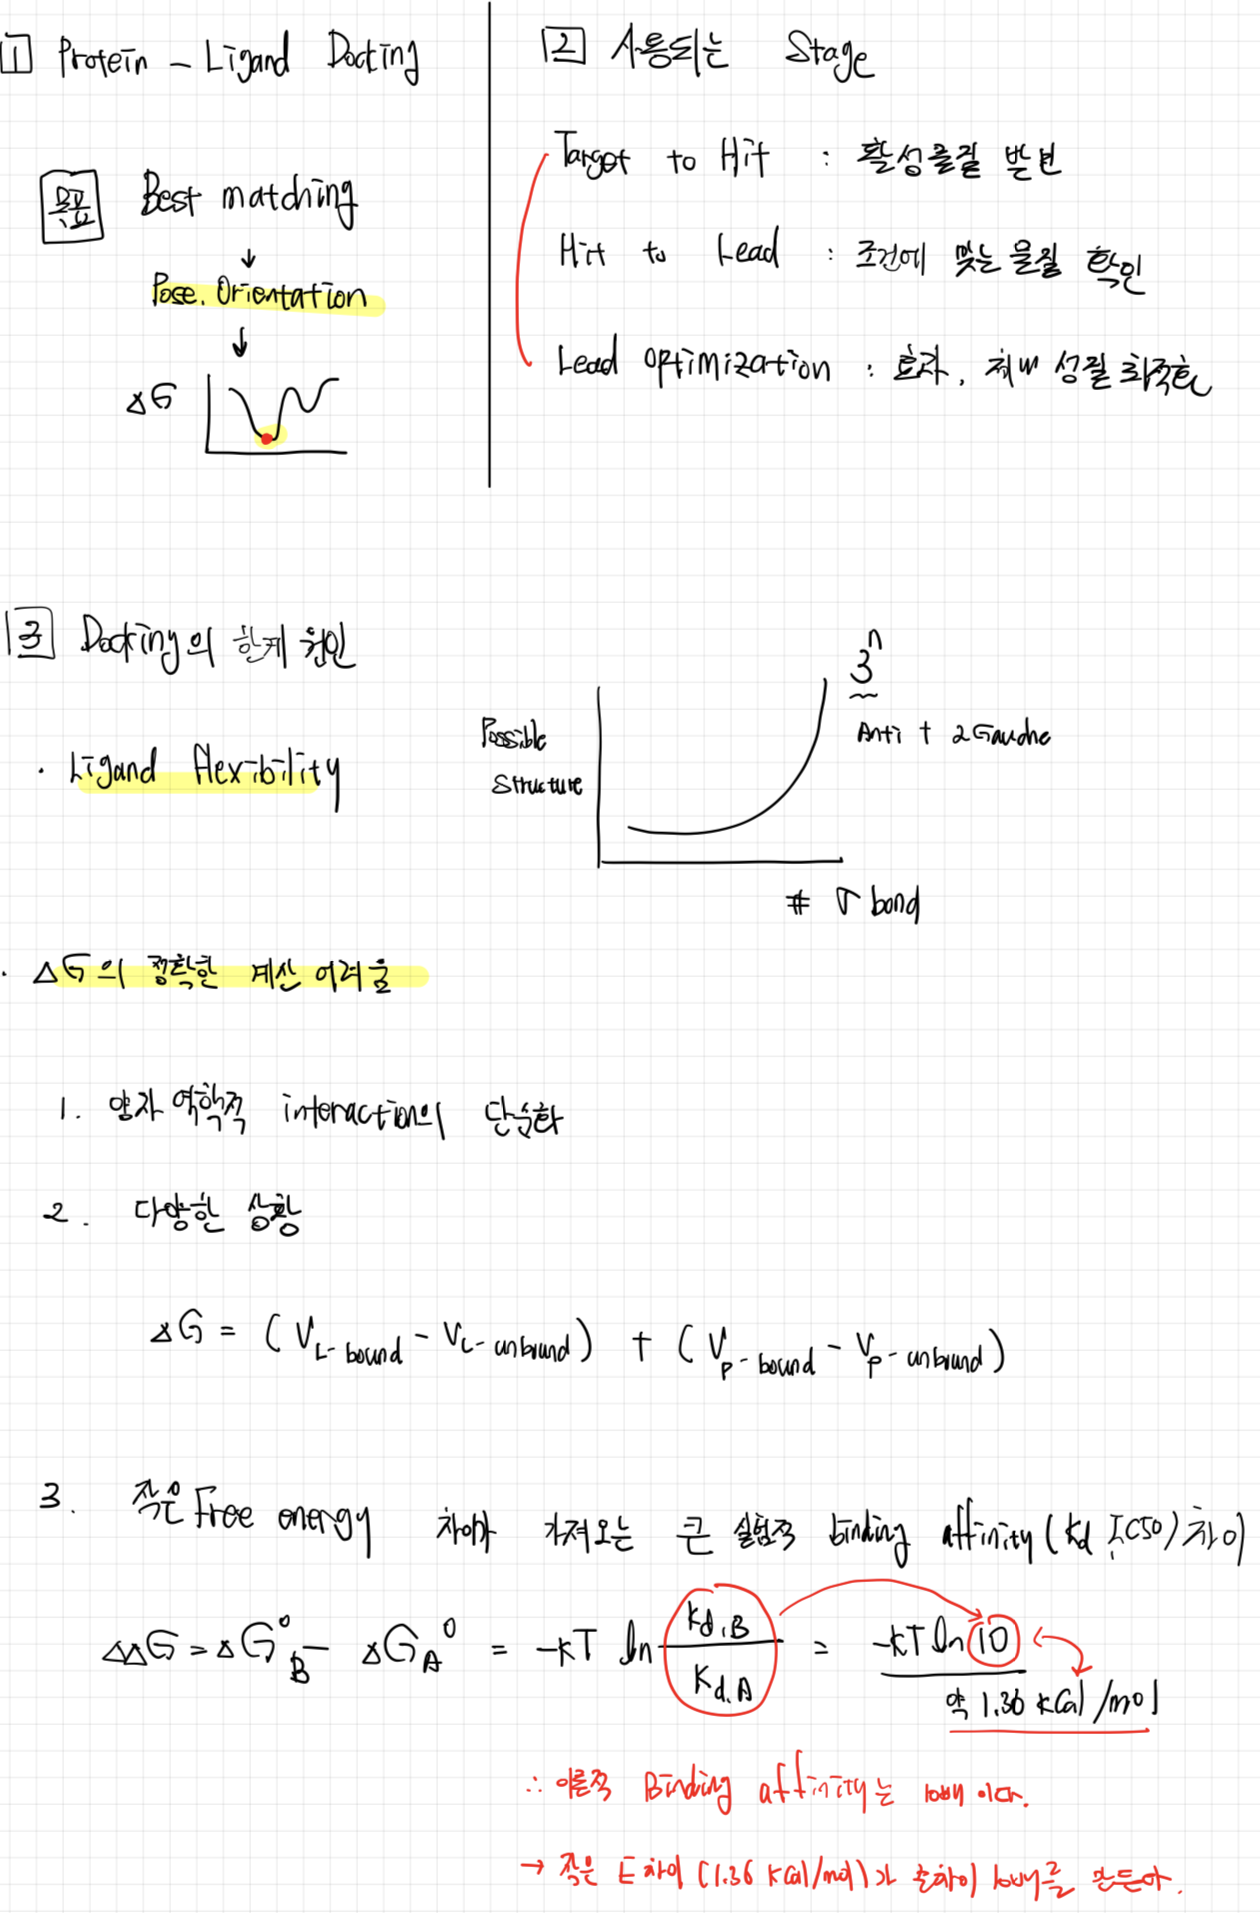
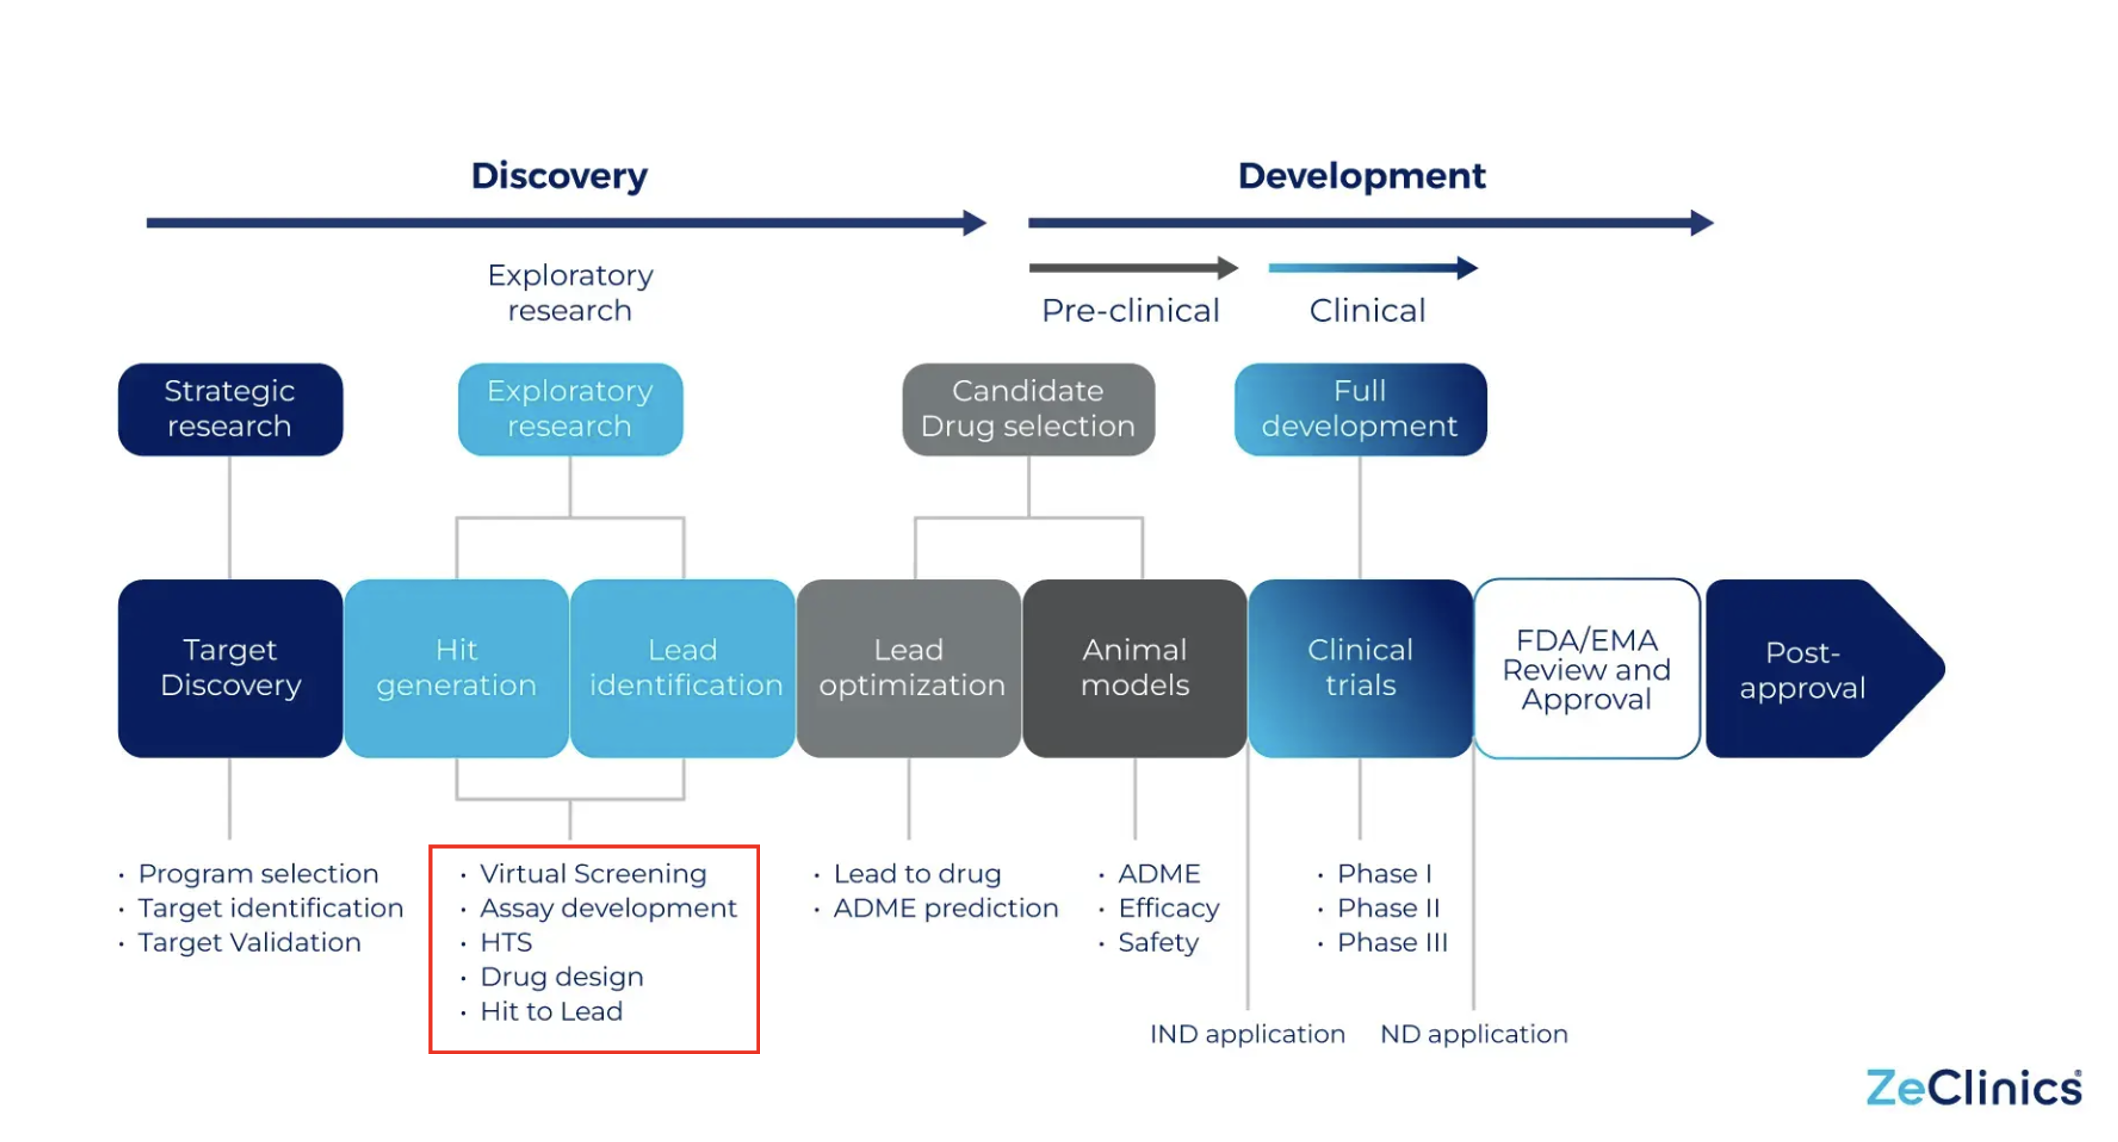
- Protein-Ligand docking 이 신약개발에서 가장 많이 사용 되는 stage는, 질환을 일으키는 target (protein)을 발견 한 뒤, 해당 protein을 inhibition 시킬 수 있는 small molecule을 찾는 과정에서 많이 사용 된다. (Target-to-hit, Hit-to-lead, Lead optimization 단계)
- Target-to-hit (표적에 작용하는 물질이 있는가?): 질병을 일으키는 단백질에 작용하는 활성이 발견된 물질 -> 실험으로 측정 오류나 비특이적 효과를 걸러내는 단계
- Hit-to-lead (이 물질을 아래 항목으로 평가하여 약 개발의 출발점으로 삼을 수 있는가?): 유사한 화합물을 만들면서 아래 항목들을 확인하는 단계
- 활성/효력 (원하는 효과를 충분히 낮은 농도에서 내는가?), 선택성 (목표 외 표적에는 덜 작용하는가?), 용해도/투과성 (녹아서 필요한 곳에 도달할 가능성이 있는가?), 대사 안정성 (체내에서 너무 빨리 분해되지 않는가?), 초기 안정성 (세포 독성 등 우려되는 신호가 있는가?)
- Lead optimization (효과,체내 노출, 안정성 등을 갖춘 개발 후보로 만들 수 있는가?): 효과와 체내 성질을 함께 최적화
- 효력/선택성: 원하는 표적에 충분히 작용하는가?
- 약동학(PK): 투여후 흡수되고, 필요한 조직에 도달하고, 적절한 시간 동안 유지 되는지?
- 약력학 (PD), 효능: 실제로 표적을 조절하고 질병 모델에서 효과를 나타내는지?
- 안정성: 효과가 나타나는 용량과 독성이 나타나는 용량 사이에 여유가 있는지?
- 제조, 제형 합성이 가능하고 안정적으로 보관, 투여 할 수 있는가?
- 예를들어 in vitro에서는 매우 강력하지만, 간에서 즉시 분해되는 물질보다, 활성이 조금 약해도 체내 노출과 안정성이 좋은 물질이 더 나은 후보가 될 수 있음.
- 하나의 신약을 개발하는데는 약 13년, $9억 (1조 2천억)의 개발 비용이 필요 하다고 한다.
2. Docking의 적용 한계를 만들어 내는 원인
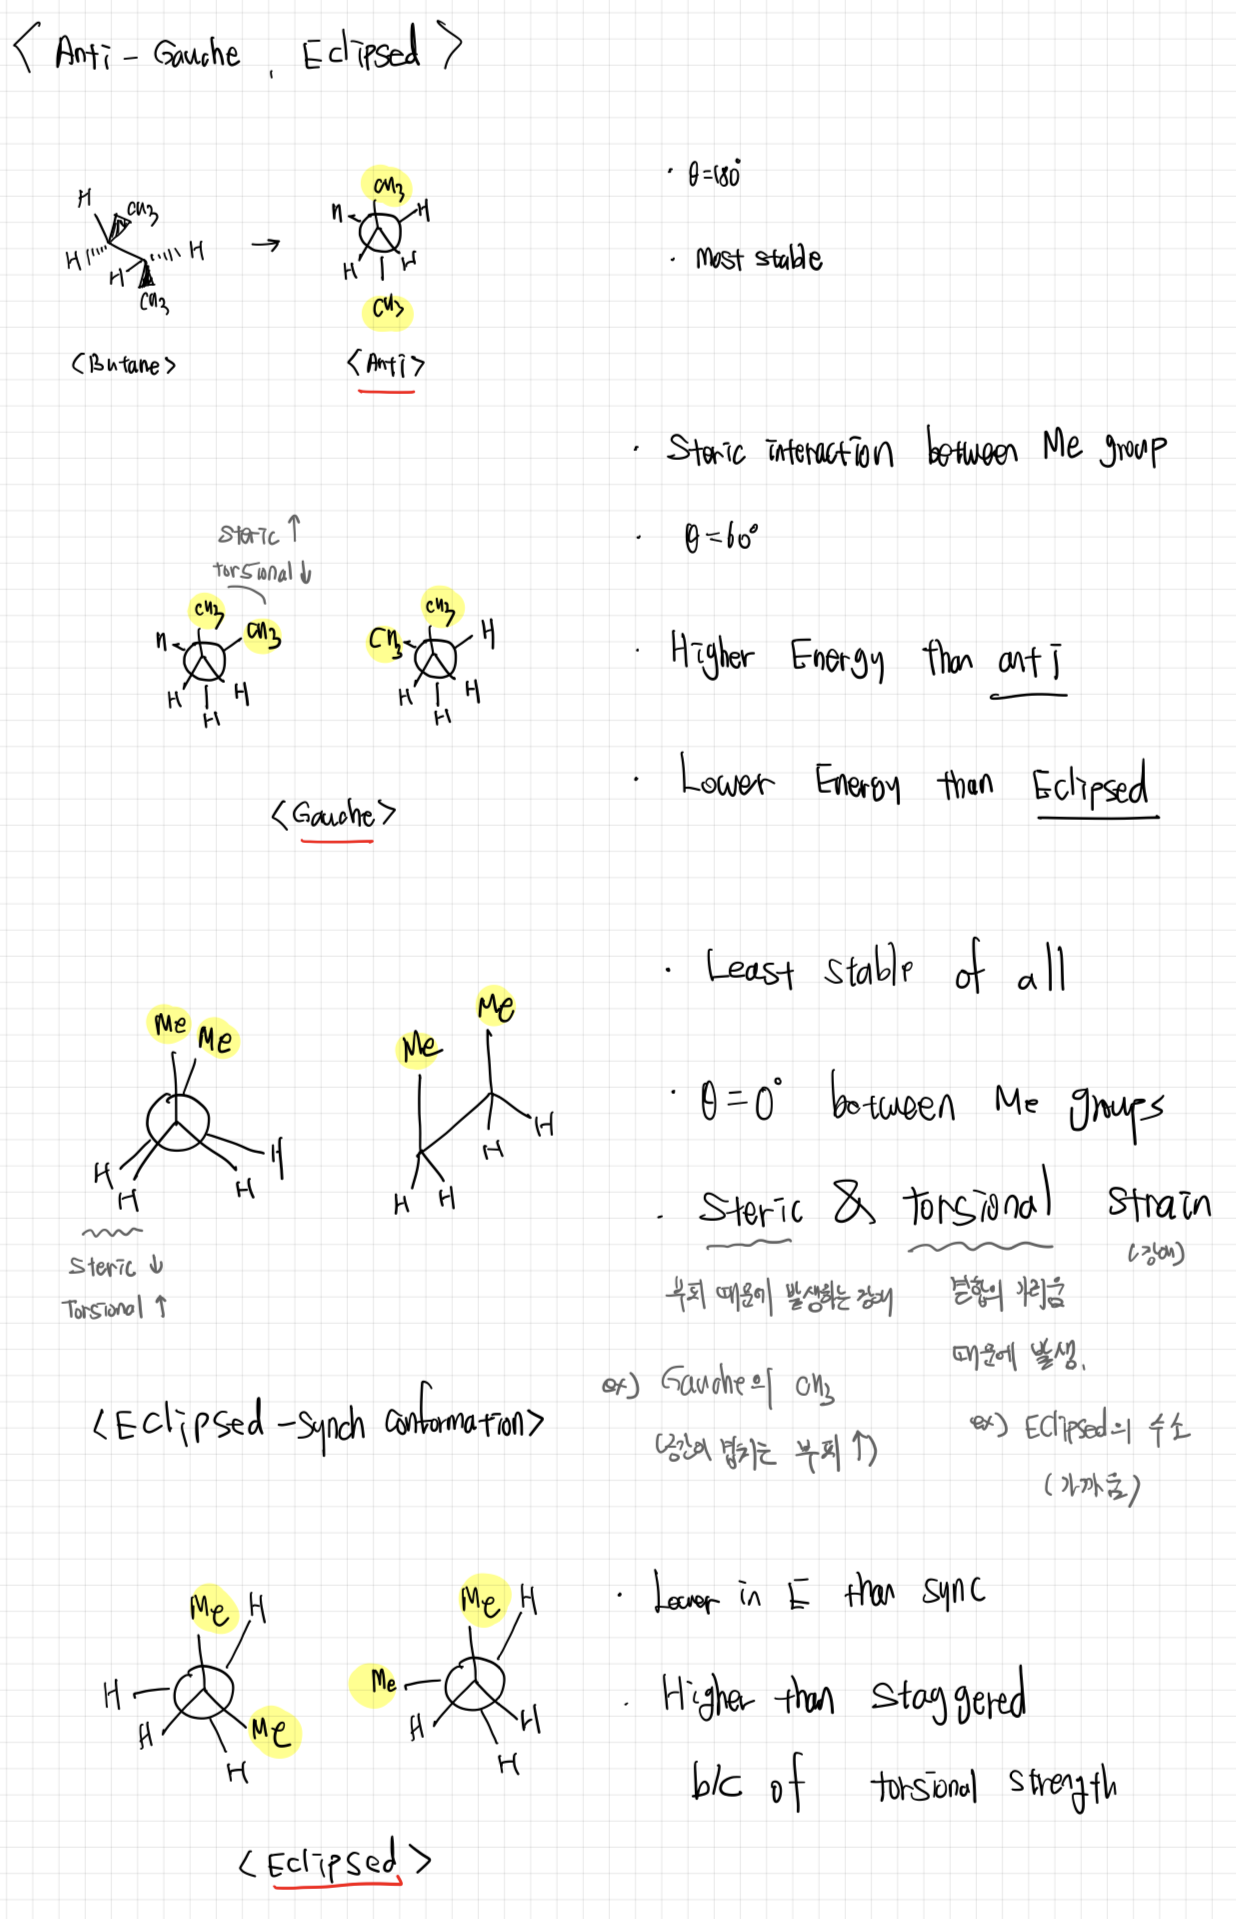
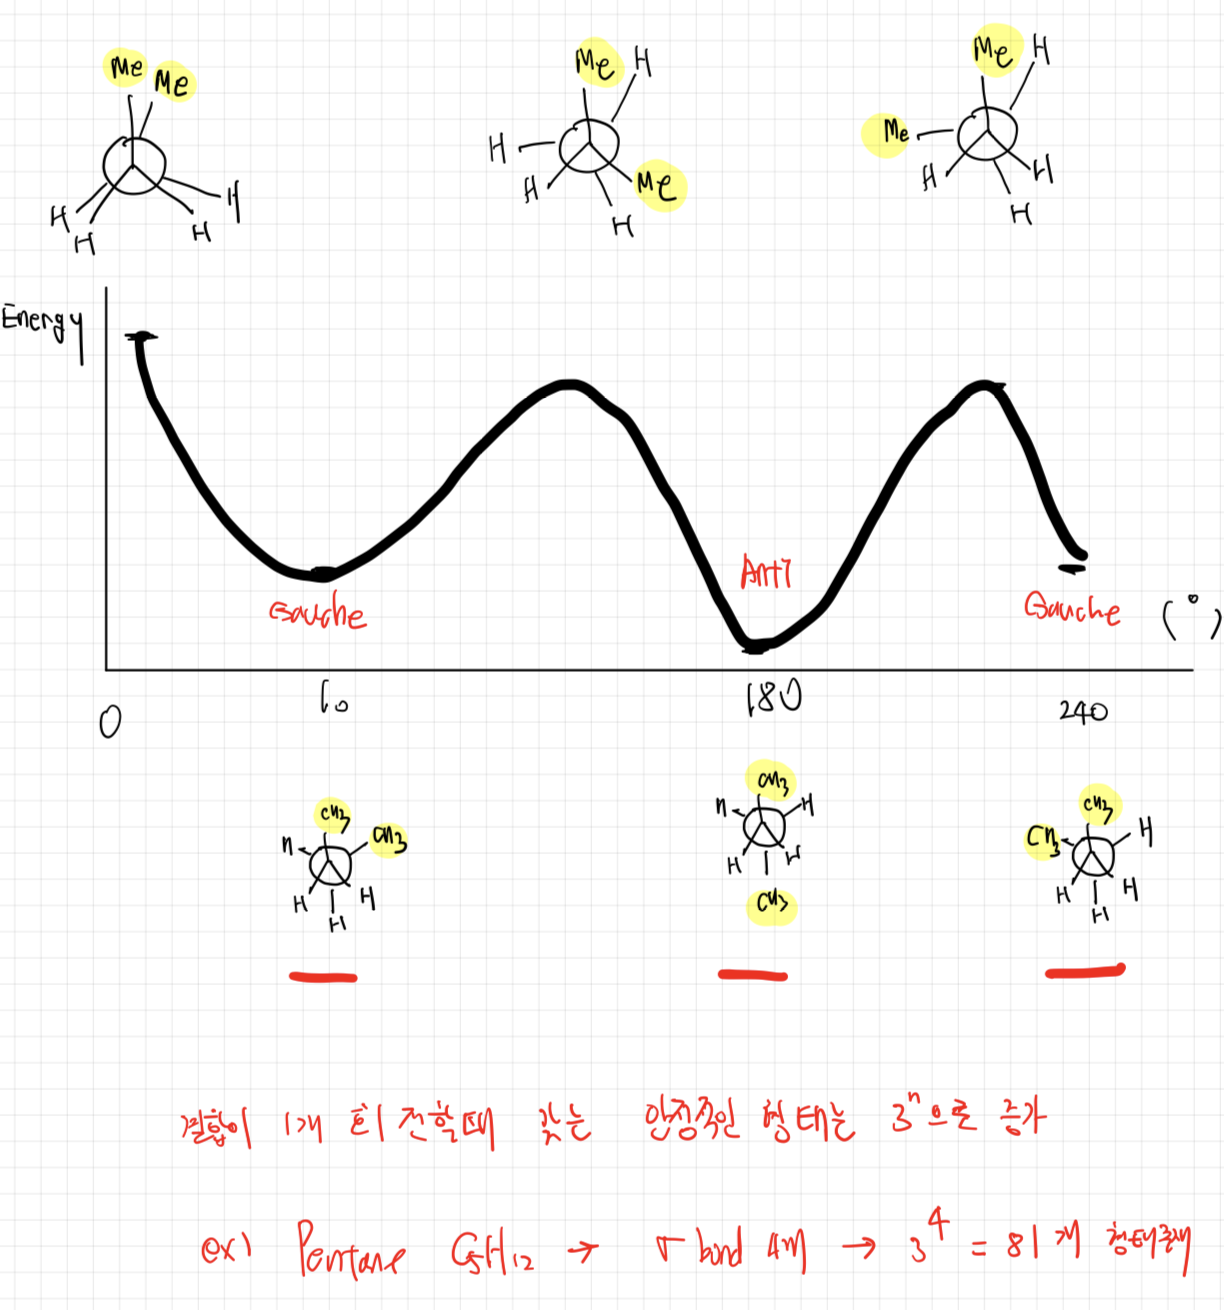
2.1. Ligand flexibility: 리간드는 다양한 형태를 가진다.
회전이 가능한 sigma bond (single bond) 의 개수의 (Anti 1 + Gauche 2) 3제곱 만큼 구조 가능성이 생기므로, 다양한 binding pose가 생겨 ligand binding site가 불명확 하다.
2. Scoring problem: Binding free energy (=binding affinity, 결합 친화도)을 정확히 계산하는 것은 어렵다.
이유 1) 양자역학적 상호작용 계산의 단순화에 따른 오류: 양자역학적으로 단백질을 이루는 모든 원자를 계산하면 정확한 에너지 계산이 가능하지만, 이는 현재 있는 컴퓨터로도 단백질을 이루는 모든 원자의 양자역학을 계산하기에는 물리적인 시간이 오래 걸린다. 따라서, 이를 단순화 시켜서 계산해야 하는데, 단순화 시키는 과정에서 양자역학적 상호작용을 단순화 시켜 오차가 발생한다.
이유 2)Protein, Ligand 개별 및 복합체 interaction 고려: Ligand, Protein 단독으로 있을 때 내부의 원자들 interaction과 docking 후, ligand-protein interaction을 모두 고려 해야하기 때문에 정확하게 계산하기 어렵다.
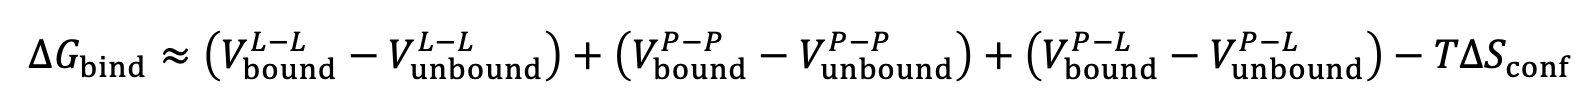
- L-L: Ligand는 그 자체로 flexible하여 결합전 구조적 다양성과, 결합 후 ligand state가 모두 고려 되어야 한다.
- P-P: Protein 자체의 결합 전, 후도 고려 되어야 한다.
- P-L: 마찬가지로 결합 전 후 모두 고려 되어야 하며. + 결합 했을 때, 구조 변화에 따른 엔트로피 계산도 필요하다 (이때, ligand flexibility가 많아 계산이 어려워진다.)
- 또한, IC50에 따른 자유에너지를 생화학적으로 구하는 binding affinity 계산과 scoring function을 통해 추론하는 free energy 계산과 잘 맞지 않는 것이 scoring function의 한계에 따른 docking의 challenge이다. 이러한 affinity를 AI와 ML로 해결하려는 것이 계산화학의 과제이다.
내 의견
Protein docking simulation이 한계점을 가지지만, 눈에 보이지 않는 것을 설명하는 열역학, 양자역학들의 연결로 눈에 보이는 하나의 생명현상을 설명하는 과정을 이론과 컴퓨터 계산으로 해낼수 있다는 점, 물리적으로 비교 불가능한 일들을 컴퓨터로 screening을 해낼 수 있다는 것이 계산화학의 매력인거 같다. 그리고 이러한 실험적인 한계점을 극복하는 것이 AI/ML이라면 이들이 가지는 potential로 이 문제를 풀어보고 싶다.
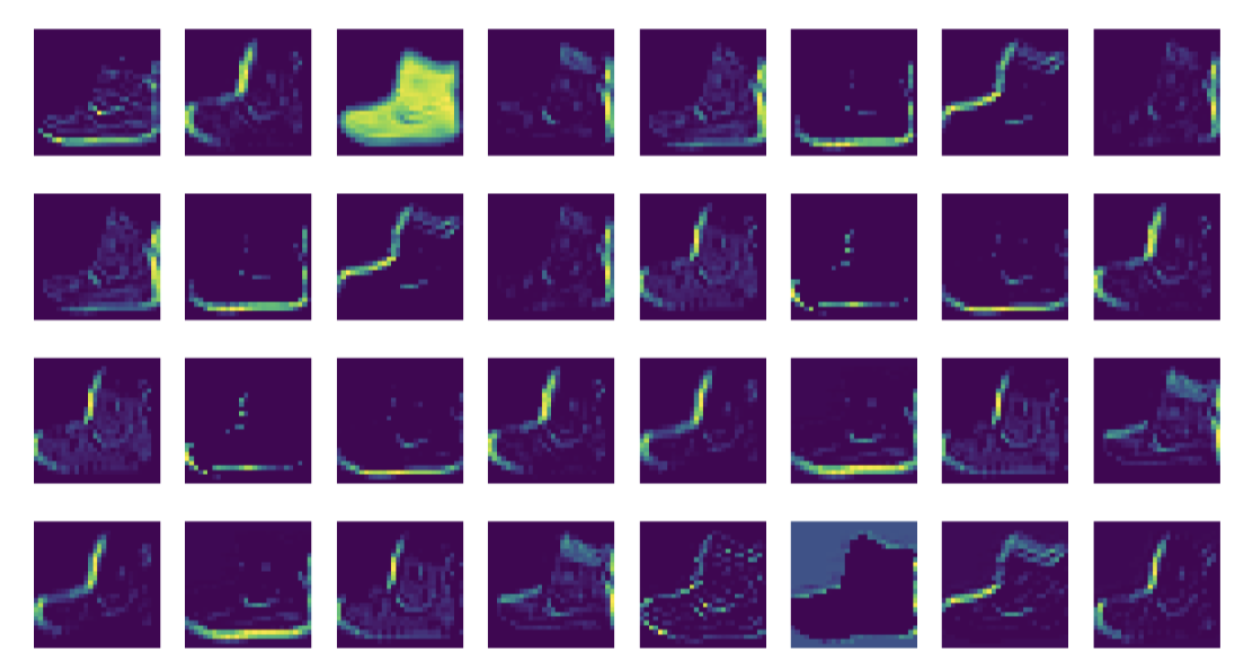
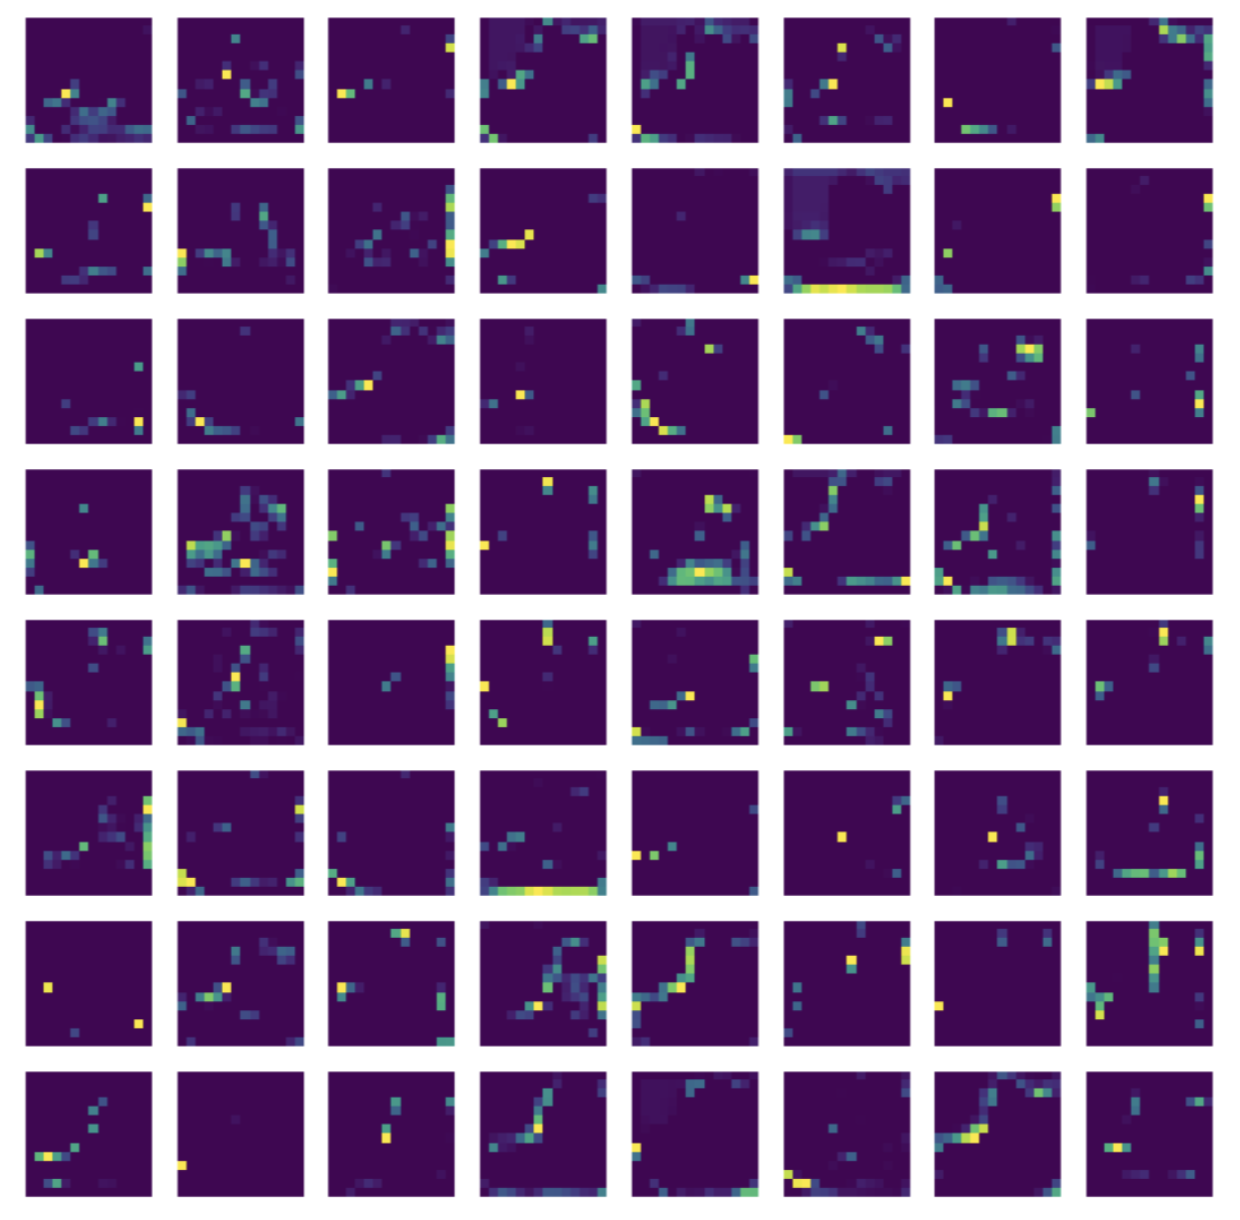
실제로, convolutional neural network를 공부 할 때, 얕은 층의 가중치는 target을 학습하는것 처럼 보이는데, 깊은 층의 가중치는 알수 없는 무언가를 학습하는 것으로 보이는데, 이는 좋은 performance를 낸다. 따라서, 이러한 AI와 함께하는 potential이 있다면, protein-ligand docking은 더 빠른 속도로 발전할수 있지 않을까 생각한다.